Il 7 ottobre 2026 Unsloth ha pubblicato la beta v0.1.904-beta: si può addestrare in locale un decision model sullo stampo di Jev, Laya e Clef. Il modello non completa frasi. Legge uno stato, riceve domande a opzioni chiuse e restituisce una scelta con una probabilità.
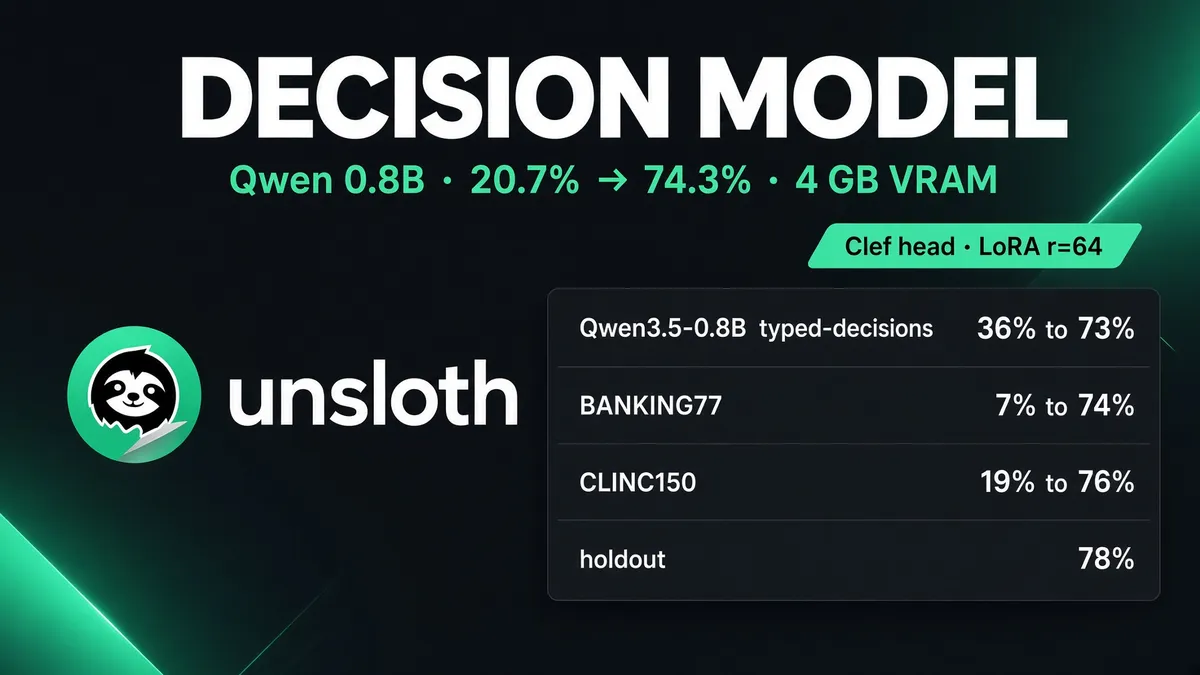
L’annuncio è nel post di Unsloth AI. La procedura sta nella guida ufficiale e nel repo. Il claim centrale: Qwen3.5-0.8B passa dal 20,7% al 74,3% di accuratezza aggregata su tre benchmark, con 4 GB di VRAM.
Cosa cambia rispetto a un LLM
Un decision model non fa decoding token per token. Unsloth attacca una testa in stile Clef al backbone, allena con LoRA e in inferenza assegna un punteggio a ogni opzione ammessa. I tipi di domanda sono gli stessi già serviti da Laya nell’app: noul (sì/no), choice (una opzione) e score (una scala).
Il riferimento commerciale è Jev di TypeSafe, il modello decisionale con training RLCD di cui abbiamo già scritto. Qui non si clonano i pesi. Si riapre il formato: stato, domande, risposta gold. Unsloth dice che il dataset di training è lo stesso usato da Laya e Clef. Clef, pubblicato da Cloudflare il 1 ottobre 2026, è un’altra cosa: Clef a 27B da Qwen3.8-27B e Clef-Flash a 9B, pesi Apache 2.0 su Hugging Face, API compatibile Jev. Unsloth non rilascia un nuovo foundation model. Rilascia il modo di fabbricarne uno piccolo sui propri dati.
I numeri su Qwen3.5-0.8B
L’aggregato del post è la media di tre salti, pubblicati anche nella guida:
- typed-decisions: 36% → 73%
- BANKING77: 7% → 74%
- CLINC150: 19% → 76%
La media prima è 20,7%. Dopo è 74,3%. L’holdout, misurato a parte, è 78%.
Il run descritto nel post usa una testa Clef, LoRA r=64 e una sola epoca. L’accuratezza downstream, che Unsloth chiama circa il livello del caso, passa dal 30–37% fino al 78%. I test sono stati decontaminati rispetto al training.
Il mix di dati conta 12 fonti più typed-decisions: ag_news, arc, banking77, boolq, clinc150, commonsense_qa, mmlu, mnli, prompt_injections, snli, sst5 e wanli. Il test ha 3.000 righe: 2.000 da typed-decisions, 500 da BANKING77 e 500 da CLINC150.
Qwen3.5-2B non racconta la stessa storia su ogni colonna. typed-decisions sale da 33% a 78%, ma BANKING77 si ferma al 58% e CLINC150 al 62%. L’holdout però è più alto: 81%. Il modello più grande non vince su tutti i task a molte classi.
VRAM, tempi e modelli che entrano
La tabella della guida, stessa pagina del training:
- Qwen3.5-0.8B: 78%, 4 GB, 42 minuti
- Qwen3.5-2B: 81%, 8 GB, 40 minuti
- Llama 3.2 3B: 79%, 4,1 GB, 30 minuti
- Gemma 4 E4B: 77%, 14,4 GB, 49 minuti
- Laya già decisionale, poi fine-tuned: 77%, 2,5 GB, 10 minuti
Un tentativo corto è previsto: max_steps = 60. Unsloth scrive che Qwen3.5-4B ha raggiunto il 76% in 10 minuti su una L4. In predizione il contesto letto arriva a 16.384 token; in training si taglia la coda dell’input e si tengono domanda e opzioni.
La ricetta consigliata in UI per avvicinarsi ai risultati non coincide col run del post. Nella guida: 2 epoche, rank 16, learning rate 2e-4. Il learning rate della testa è 1e-4. Batch 8, accumulation 4, cosine, 10 warmup, weight decay 0,01. Se manca memoria, si dimezza il batch e si raddoppia l’accumulation.
Un dato di community, non un benchmark: Leo Borcherding di Unsloth ha riportato un Laya su RX 6500 XT da 4 GB, 40 step e 25 secondi, da 50% a 93% su decisioni mai viste. È un caso singolo.
Come si allena, in Studio e in codice
In Unsloth Studio si apre Train, si sceglie un LLM (l’esempio della guida è unsloth/Qwen3.5-4B) e si imposta Train as su Decision model. Il dataset si carica da file o da Hugging Face. Per typed-decisions il subset è all. A fine run lo Studio mostra l’accuratezza held-out prima e dopo, e calibra la confidenza.
Il pulsante Use in Decision API dirotta le richieste laya, default e jev-latest sul modello appena allenato. La pagina di serve, Laya + Jev API, espone già Laya e Clef con un’API compatibile TypeSafe, così un client scritto per Jev può puntare al server locale. I dati restano sulla macchina. CPU, memoria unificata e GPU sono supportate; se la GPU va in out-of-memory, Laya torna in CPU.
In Python il percorso è FastDecisionModel.from_pretrained con load_in_4bit = True, poi get_peft_model, build_dataset e DecisionTrainer. La calibrazione si fa sulle righe tenute fuori da split_holdout, e restituisce accuratezza, ECE e loss. Si salvano gli adapter più la testa, oppure un merge a 16 bit. La release aggiunge export GGUF per i Clef con backbone Qwen3.5 e per Laya, e il serve via llama.cpp, anche per modelli che leggono immagini.
Licenza da non ignorare. I file sotto unsloth/, tests/ e scripts/ sono Apache 2.0. Studio e CLI, installazione opzionale, sono AGPL v3.
Dove ha senso, e dove no
Il caso netto è il router. BANKING77 ha 77 intent: un 0,8B che passa dal 7% al 74% e restituisce una probabilità può smistare il ticket e chiamare il modello grande solo se è incerto. Lo stesso schema vale per filtri email, tag, invoice e trace di agenti, che è il sottoinsieme “typed decisions” indicato da Unsloth.
Non è un sostituto dei decision model grandi sui leaderboard pubblici. Clef, nel post Cloudflare, guida il Jev Decision Index e su BANKING77 riporta un macro-F1 di 94,20, contro 79,74 di Jev. Quei numeri non sono lo stesso protocollo del run Unsloth, e non vanno messi sulla stessa riga. Un 0,8B allenato una epoca non è un 27B post-trained.
Il 2B che perde sul 0,8B in due colonne è il promemoria utile: la testa e i dati pesano più del parametro in più, e un holdout unico non basta a dichiarare il modello vinto. Vale la pena misurare ECE dopo calibrate, non solo l’argmax.
Fonti
Testo: assistito da AI · revisionato da Carlos H. P. Ross