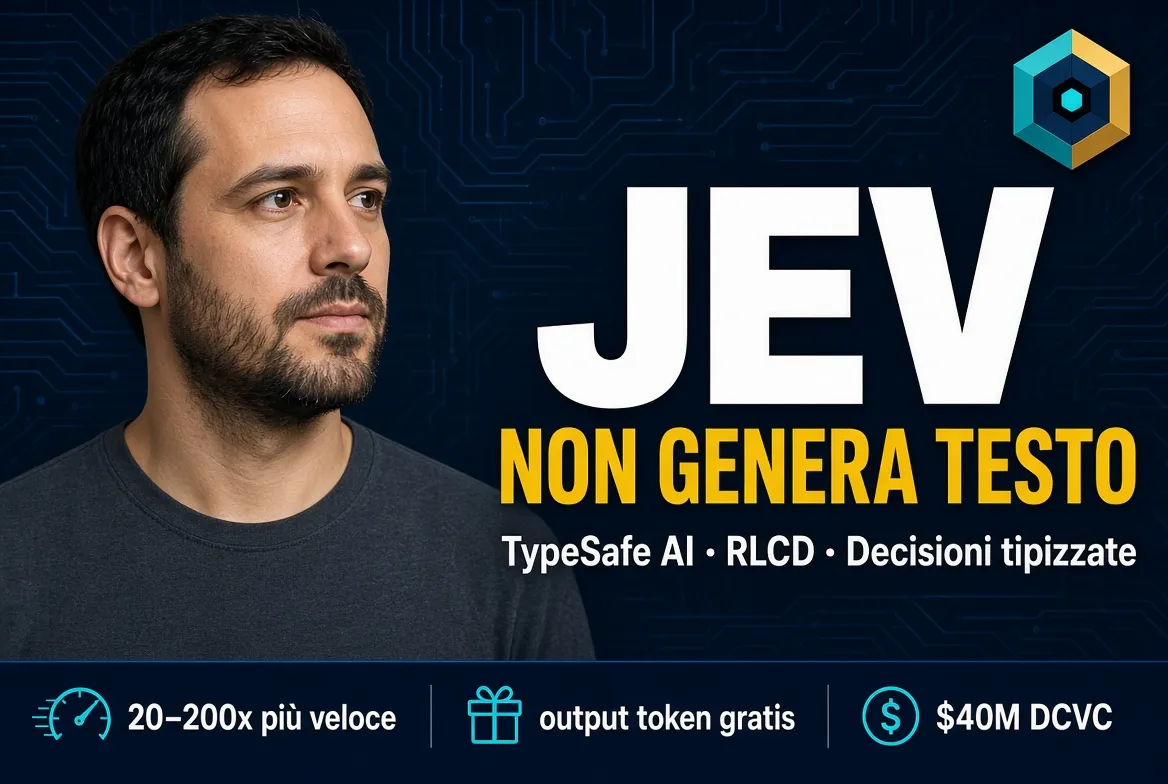
Il 15 settembre 2026 TypeSafe AI è uscita dallo stealth con Jev, il suo primo modello pubblico. Il tweet di lancio parlava di una nuova via verso l’AGI e di una rivoluzione economica. Il prodotto reale è più stretto e più interessante: un modello che non genera testo e restituisce decisioni tipizzate che il codice può consumare direttamente.
Jev è classificato dall’azienda come System One Model, nome preso da Thinking, Fast and Slow di Daniel Kahneman. L’idea è un giudizio veloce, non una risposta in prosa. Mandi uno state (testo o dati strutturati) e una mappa di domande. Il modello valuta le domande in parallelo e torna valori tipizzati con probabilità e confidence.
Cosa fa Jev, e cosa non fa
Le primitive ufficiali sono tre, documentate su docs.typesafe.ai:
- Noul: quanto è vera un’affermazione, su una scala 0–1.
- Choice: una scelta da una lista (enum), con distribuzione di probabilità.
- Score: un punteggio su una rubrica, con probabilità e confidence.
Non scrive email. Non scrive codice. Non spiega il ragionamento. Almeida lo ha detto senza giri di parole: i guadagni di velocità non sono gratis, Jev can’t generate text. Non è un sostituto drop-in di un LLM e, per i task per cui è pensato, l’azienda lo valuta oggi intorno a 8,5/10.
Il “non può allucinare” va letto nello stesso senso. Jev non inventa stringhe fuori schema. Può comunque sbagliare la decisione. La calibrazione, secondo i docs, vale sui gruppi di predizioni: una probabilità 0,8 dovrebbe avverarsi circa l’80% delle volte, non su ogni singolo caso.
RLCD al posto di RLHF
Il metodo di training si chiama Reinforcement Learning for Calibrated Decisions (RLCD). TypeSafe lo contrappone a due linee già note:
- RLHF, ottimizzato per risposte che i valutatori umani preferiscono.
- RLVR, ottimizzato per output verificabili in modo programmatico.
RLCD ottimizza per decisioni con probabilità “epistemicamente oneste” su task System One. L’architettura e lo sampler parallelo non sono aperti: non c’è un paper peer-reviewed al momento del lancio, solo blog, docs e demo.
Il fondatore Diogo Almeida è co-autore del paper InstructGPT (Training language models to follow instructions with human feedback, 2022), il lavoro RLHF di OpenAI da cui è arrivato ChatGPT. “Co-inventore di ChatGPT” è marketing. Co-autore del paper che ha reso utili i modelli a seguire istruzioni è il dato verificabile. Con lui fondano TypeSafe Erik Gafni e Sasha Sheng. Sede a San Francisco, company nata nel 2024.
Numeri dichiarati, e dove nascono
Sul blog ufficiale TypeSafe pubblica questi range:
- Latenza end-to-end: 70–500 ms, contro secondi o minuti dei frontier LLM sulle stesse query System One.
- Velocità: 40x–200x (il tweet usa 20–200x).
- Costo: 40x–400x più basso, con output token a zero.
- Prezzo listino: $0,042 per milione di token in input (42 dollari per miliardo). Output “too cheap to meter”.
- Homepage: su workflow interni, 193,6x più veloce e 444,6x più economico (0,114 s e $0,000081 contro 8,566 s e $0,013880). Questi multipli arrivano da eval proprietari su grafi di workflow, non da MMLU, GPQA o un harness pubblico indipendente. Il confronto è con modelli chat/ragionamento usati come motori di decisione, cioè nel caso d’uso in cui un LLM è più lento per costruzione. Finché non arrivano benchmark terzi, vanno trattati come claim aziendali.
Il 15 settembre TypeSafe ha anche annunciato un seed da 40 milioni di dollari guidato da DCVC. Early access su waitlist, console su console.typesafe.ai, eval pubblici su evals.typesafe.ai, adapter Python su GitHub.
Dove può servire, e dove no
I casi d’uso credibili sono quelli in cui oggi si forza un LLM a emettere JSON e poi si parsa:
- routing di ticket o di modello;
- guardrail e lint semantici in CI;
- scoring di urgenza, rischio, qualità;
- feature probabilistiche da testo per modelli predittivi;
- controlli intermedi dentro un agent, senza pagare una generazione completa.
Mike Taylor su Every ha raccontato un test concreto: 37 documenti, 21 domande ciascuno, 777 giudizi in meno di 0,7 secondi, costo stimato di un quarto di centesimo. È il tipo di carico in cui un chatbot è sprecato.
Non è la via più corta all’AGI. È un’API di giudizio veloce, cara da vendere come frontier model e utile da usare come primitiva. Chi costruisce agent dovrebbe provarla sui rami “decidi e vai avanti”, non sostituire il modello che scrive.
Testo: assistito da AI · revisionato da Carlos H. P. Ross