Il 29 settembre 2026 Voltropy, laboratorio di Irvine in Orange County e public benefit corporation, ha presentato Vast-10M: una famiglia di LLM con context nativo da 10 milioni di token. Non è una finestra estesa a posteriori con retrieval. È il context del modello, dichiarato pienamente usabile fino a quel tetto.
Il claim commerciale è netto. La finestra è 10 volte quella di Fable 5.1 di Anthropic e 9,5 volte quella di GPT-6 Astra di OpenAI, che il press kit indica a circa 1,05 milioni di token. L’early access è aperto dallo stesso giorno su voltropy.com. Pesi e API pubbliche, al momento dell’annuncio, non ci sono.
Tre taglie sullo stesso tetto
VSA, Voltropy Scalable Attention, è l’algoritmo che allunga il context. Non nasce un modello da zero. L’attenzione nuova viene innestata su tre basi aperte, come descritto nel technical report firmato da Clint Ehrlich e Ted Blackman.
- Vast-10M-Flash, flagship, su DeepSeek V4.0 Flash.
- Vast-10M-Medium su GLM-5.2.
- Vast-10M-Pro su DeepSeek V4.0 Pro.
Tutte e tre dichiarano 10 milioni di token nativi. Flash è il modello su cui poggia il confronto con i flagship chiusi. Medium e Pro servono a mostrare che il guadagno non è un caso singolo.
Cosa cambia rispetto al base model
Il report misura BEAM (Beyond a Million Tokens) a 100k, 500k, 1M e 10M. Il giudice è gpt-4.1-mini a temperatura 0, con la formula ufficiale del benchmark, sul commit 3e12035532eb85768f1a7cd779832b650c4b2ef9. I campioni sono 400 domande a 100k, 700 a 500k, 700 a 1M e 200 a 10M.
Vast-10M-Flash segna 52,66 / 50,22 / 48,73 / 40,20. Il base DeepSeek V4.0 Flash è a 43,71 / 44,72 / 39,69 e non ha un punteggio a 10M. Il delta di Flash è +8,95 a 100k (+20,48%), +5,50 a 500k (+12,30%) e +9,04 a 1M (+22,77%).
Pro passa da 42,28 / 41,05 / 38,02 a 43,93 / 44,50 / 43,76, e a 10M fa 36,09. Medium passa da 39,50 / 40,49 / 40,06 a 49,02 / 44,75 / 45,67, e a 10M fa 32,74. Ogni conversione VSA batte la propria base alle lunghezze condivise. Il report dice anche che il retrofit non ha richiesto un retraining esteso: è un’affermazione della società, non un controllo di fine-tuning pubblicato.
Il confronto con Fable 5.1 e GPT-6 Astra
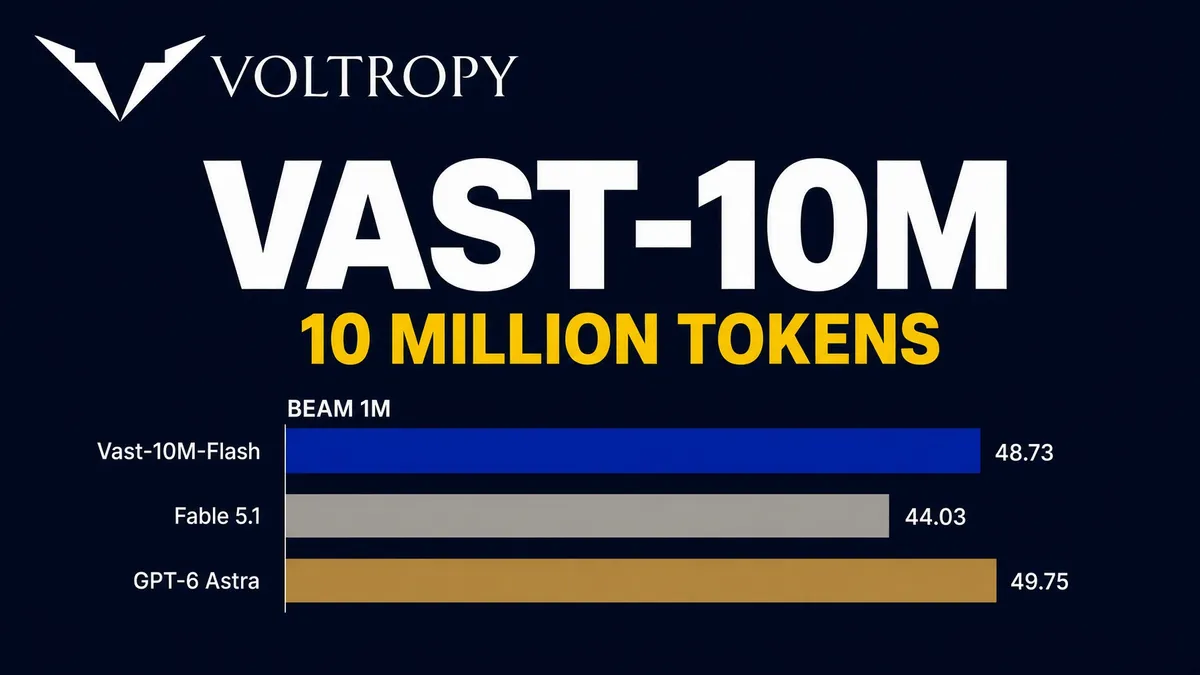
Il grafico ufficiale, nel press kit, è al tier da 1 milione. Vast-10M-Flash fa 48,73. Fable 5.1 fa 44,03. GPT-6 Astra fa 49,75. Flash supera Fable di 4,70 punti e raggiunge il 97,95% di Astra. È la “parity” del comunicato: un punto di distacco, non un pareggio aritmetico.
A 10 milioni Flash resta a 40,20. Trattiene l’82,49% del proprio score a 1M. Quel 40,20 è sopra i 39,69 del DeepSeek V4.0 Flash a 1 milione: il dato che la società usa per dire che l’intera finestra è funzionale. Da 100k a 10M il calo relativo è del 23,67%, da 52,66 a 40,20. Una lettura indipendente del report, pubblicata da FourWeekMBA il 30 settembre, aggiunge il contesto corto dei modelli chiusi: a 100k Fable 60,98 e Astra 55,56 contro Flash 52,66; a 500k Fable 57,26 e Astra 56,15 contro Flash 50,22. Se quei numeri reggono, Flash non guida sotto il milione. Supera Fable a 1M perché Fable cade di più, non perché Flash salga. Il crossover è reale. La cornice “batte i flagship” vale solo a quella lunghezza.
Cosa il report non dice
Non ci sono parametri, latenza, throughput, memoria o prezzo per token. Non c’è un controllo che isoli VSA da qualsiasi fine-tuning residuo. I tier BEAM non sono lo stesso compito: le fasce alte aggiungono conversazioni e domande. Il tier da 10M poggia su 200 domande, il campione più piccolo. La tokenizzazione può ridurre la finestra effettiva sotto la lunghezza nominale; in quel caso il report segue la procedura ufficiale di troncamento.
Per un team che valuta un context da 10M, questi buchi contano quanto il punteggio. Senza costo e senza latenza, 40,20 a 10 milioni non dice se il modello è usabile in produzione.
Early access e uso concreto
L’iscrizione è su voltropy.com. Ehrlich, CEO, ha indicato come casi d’uso l’intero codice fiscale USA o i transcript delle earnings call di tutto l’S&P 500. Blackman, CTO, ha scritto che il guadagno a context corto non era il risultato atteso. L’annuncio è sul profilo Voltropy.
Voltropy arriva a questo modello dopo LCM, Lossless Context Management, un’architettura agentica già usata per battere Claude Code su OOLONG in lavori precedenti del laboratorio. Vast-10M è la prima famiglia di modelli propria. Non sostituisce un indice o un file system. Sposta il punto in cui il context nativo smette di essere il collo di bottiglia.
Fonti
Testo: assistito da AI · revisionato da Carlos H. P. Ross