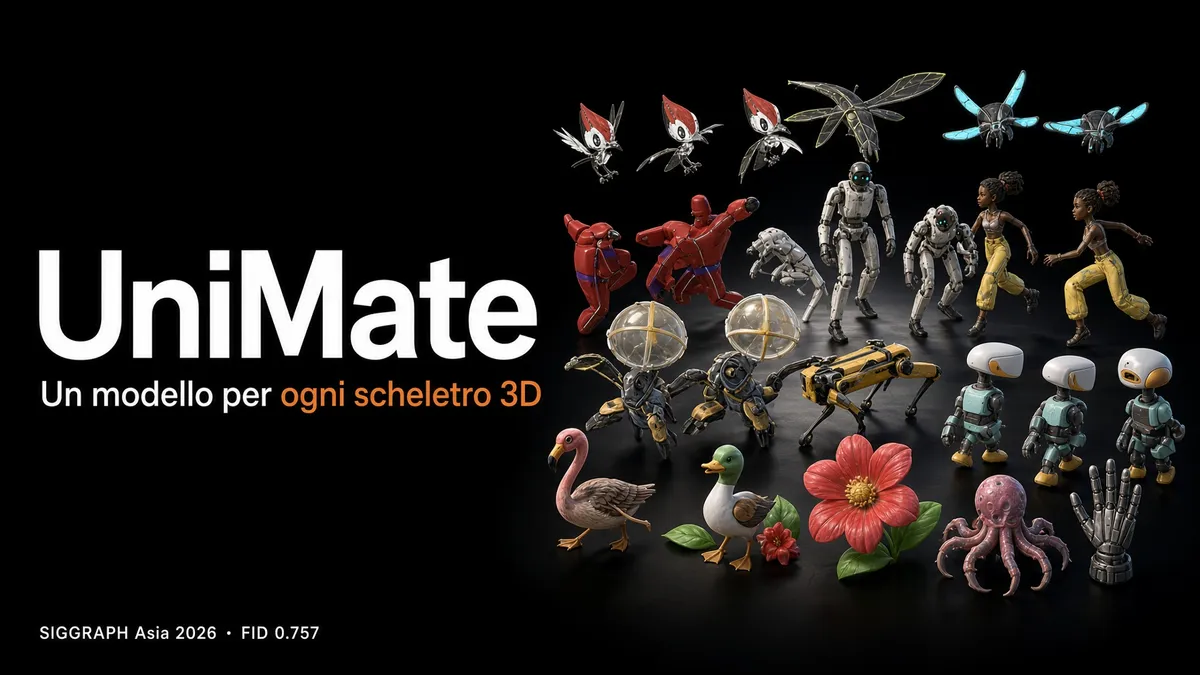
UniMate è un foundation model che sintetizza motion articolato per scheletri di topologia arbitraria a partire da un asset 3D già riggato e da un prompt di testo. Non serve un retraining per scheletro e non c’è ottimizzazione a test-time. Il paper, accettato a SIGGRAPH Asia 2026 (1–4 dicembre, Kuala Lumpur), è su arXiv come 2609.05415.
Il punto di partenza è pratico. Il rigging automatico consegna già asset pronti all’animazione. I modelli appresi che li muovono restano legati a un template di categoria, oppure chiedono fine-tuning e motion di riferimento in inference. UniMate tratta lo scheletro come input, non come architettura fissa.
Il modello legge il grafo, non un template
Il backbone è TADiT, Topology-Aware Diffusion Transformer, addestrato con conditional flow matching. I token uniscono feature di motion per frame e descrittori della rest pose. Ogni joint, a ogni frame, ha dimensione 12: posizione, rotazione rispetto alla T-pose e velocità.
Tre meccanismi portano la topologia dentro l’attention.
- Un bias di attention ricavato da relazioni tra joint e distanze geodetiche sul kinematic tree, così i joint vicini pesano di più senza spegnere il coordinamento full-body.
- Spec-RoPE, un rotary embedding spettrale che generalizza RoPE agli alberi cinematici tramite il laplaciano del grafo. Il paper ne indica invarianza traslazionale nelle coordinate spettrali ed equivariance alla permutazione dei joint.
- Un conditioner globale, attention-pooled dalla rest pose, che riassume l’anatomia dell’asset.
Il testo entra da un encoder frozen, google/flan-t5-base, con classifier-free guidance (dropout caption al 10%, scala default 3.0). In sampling si usa un solver di Eulero a 50 step. Una clip da 60 frame, text encoding e forward kinematics inclusi, richiede circa 1,2 secondi su una NVIDIA H100.
UniML3D: 13.006 clip, tre fonti
UniML3D raccoglie 13.006 sequenze text-paired, circa 20 ore, e 3.584 prompt unici. Le categorie coprono bipedi, quadrupedi, uccelli, animali marini, insetti, serpenti e oggetti rigidi articolati. Le azioni vanno da locomozione e combat a idle, articolazione meccanica e manipolazione.
Le fonti sono tre. Mixamo per gli umanoidi. Un sottoinsieme riggato e animato di Objaverse-XL per creature e oggetti. Truebones ZOO per gli animali. Canonicalizzazione e augmentation sono condivise; sampling bilanciato e augmentation girano on the fly in training. La loss è un L2 mascherato sul velocity field, più un termine geodetico sulle rotazioni e uno di smoothness.
Il codice e la pipeline dati sono su GitHub (rilascio codice 6 settembre 2026, dataset 30 agosto, accettazione 18 luglio). Il repo conta circa 1,4k stelle. La demo interattiva è online da agosto su linzhanmou.com/unimate/interactive.html.
Gli autori sono Linzhan Mou (Princeton, primo anno di PhD, advisor Szymon Rusinkiewicz), Jiahui Lei (UC Berkeley), Zhiyang Dou (MIT), Chenyue Cai (Princeton), Chaoyue Song (NTU) e Adam Finkelstein.
FID 0,757 e 1,2 secondi a clip
Sul test held-out Truebones, UniMate riporta FID 0,757 e diversity 9,200, contro FID 2,711 e diversity 8,139 di AnyTop (SIGGRAPH 2025, repo). Nel confronto qualitativo, su scheletri non visti, UniMate esegue la caduta del cervo e la camminata del raptor richieste dal prompt; AnyTop resta quasi fermo o non completa l’azione.
Sull’animazione mesh i numeri VBench del paper sono questi.
- UniMate: OC 0,186, MS 0,993, DD 0,833, AQ 0,544, tempo 1,214 s.
- AnimateAnyMesh (ICCV 2025): OC 0,151, MS 0,995, DD 0,352, AQ 0,498, tempo 15,542 s.
- V2M4 (ICCV 2025): OC 0,167, MS 0,991, DD 0,667, AQ 0,506, tempo 1,641 h.
Nello user study su animazione mesh la media di UniMate è 4,615, contro 2,808 di AnimateAnyMesh e 2,413 di V2M4. Il confronto non è fra metodi identici: V2M4 ricostruisce da video monocolo, AnimateAnyMesh anima mesh senza scheletro. Il dato utile è il tempo e il voto umano, non un singolo score.
Ablation interne: senza rebase della rotazione in rest pose il FID sale a 1,179; senza augmentation la diversity scende a 8,265. Con foot-locking, skate e slide passano da 0,107 / 0,542 a 0,023 / 0,191.
Transfer, in-betweening, editing
Lo stesso checkpoint copre zero-shot cross-topology transfer, in-betweening da pose iniziale e finale, editing testuale con joint fissati ed expansion a prompt consecutivi. Una variante a 180 frame genera sequenze lunghe, nel paper un lampada da tavolo, un robot anatra e un braccio che sposta un oggetto, senza drift evidente nel clip mostrato. I checkpoint preview sono su Hugging Face. Il denoiser full-mix unimate_uniml3d_f60_v3_preview (5 ottobre 2026) e la v2 hanno 74,1 milioni di parametri; la variante cross-attention ne ha 66,2 milioni; i modelli solo Mixamo e solo Truebones 47,8 milioni. Output: 60 frame a 30 fps. L’inference chiede T-pose, gerarchia e label dei joint pulite. Due condizionamenti testo: graph più adaLN, oppure full attention con cross-attention sulla caption.
Licenza e limiti da leggere prima del prodotto
Il codice è MIT. I checkpoint sono CC BY-NC 4.0: ricerca sì, uso commerciale dei pesi no, finché non cambia la card. Mixamo resta sotto licenza Adobe, Objaverse-XL sotto le licenze per oggetto, e le motion Truebones non sono ridistribuite: il dataset pubblica prompt, metadata e render, non i clip commerciali.
I limiti dichiarati contano in produzione. Foot sliding, drift, hovering e penetrazione del suolo sui motion ricchi di contatto. Topologie rare e motion fuori distribuzione sono meno affidabili: nel paper una lampada promptata a cadere sulla scrivania piega solo la testa. Non c’è controllo spaziale fine nativo, e la coda lunga delle specie resta il vincolo dei dati 4D.
Per una pipeline di asset il guadagno è chiaro se il rig in ingresso è pulito e se il prodotto può restare in ambito non commerciale, oppure se si riaddestra sui propri dati. Non sostituisce un animator su contatti precisi.
Fonti
Testo: assistito da AI · revisionato da Carlos H. P. Ross