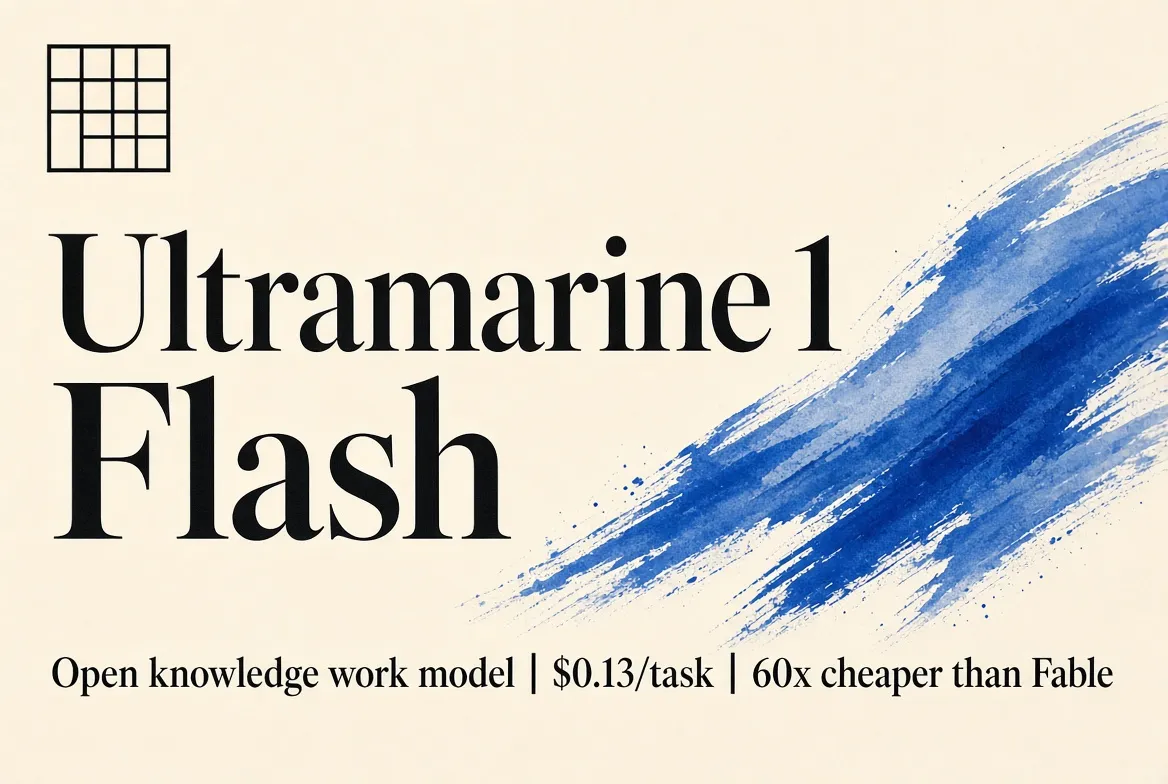
Paper Instruments ha rilasciato il 14 ottobre 2026 Ultramarine 1 Flash, un modello agentico open pensato per il knowledge work professionale. Si tratta di un post-training di GLM-5.3 Flash di Z.ai, ottenuto con reinforcement learning su larga scala applicato a task non verificabili.
Il modello punta a produrre deliverable finiti (Excel, PowerPoint, Word) e a operare all’interno di sistemi aziendali. Su PI Knowledge Work, il benchmark interno di Paper Instruments, Ultramarine 1 Flash ottiene 59.3 a 0,13 dollari per task, superando Claude Fable 5 (57.8 a 8,19 dollari) e GPT-5.6 Sol (55.1 a 2,09 dollari).
Cosa significa RL non-verificabile
La maggior parte del lavoro professionale non è verificabile con unit test o parser. Un memo di due diligence, una chronology di contenzioso o un deck di board non hanno una “risposta corretta” controllabile automaticamente. La qualità dipende da giudizio, gusto e aderenza a standard professionali.
Ultramarine formalizza ogni task di RL come ambiente + istruzione + sistema di verifica, usando rubriche con criteri binari (soddisfatto/non soddisfatto). Le rubriche sono progettate per accettare alternative valide e ridurre la varianza del giudice. Tutto il curriculum è sintetico: 19 aree di pratica, 88 tipi di ambiente, combinazioni da 10 milioni a 10 miliardi di configurazioni. Nessun task scritto da esperti e nessuna traccia di produzione.
Il training usa un obiettivo CISPO modificato con Rollout Routing Replay (R3), LoRA rank 64, contesto di 131K token e fino a 250 turni di agente. L’harness è Feather, rilasciato open source insieme al package rubric e alle librerie Paper Office (paper-docx, paper-pptx, paper-xlsx).
Risultati sui benchmark di knowledge work
Secondo il technical report di Paper Instruments, Ultramarine 1 Flash migliora il base model su tutti e sei i benchmark di knowledge work, con una media di +4.1 punti e il 6,5% di token in meno in output.
- JobBench: 62.9 (primo, Gemini 3.8 Flash 60.6, Claude Fable 5 57.4)
- PI Knowledge Work (interno): 59.3 (primo, Claude Fable 5 57.8)
- FrontierFinance: 53.3 (primo, GLM-5.3 Flash 50.7)
- AutomationBench: 50.2 (secondo, DeepSeek V4.1 Flash 51.3)
- DiligenceBench: 50.6 (terzo, Gemini 3.8 Flash 53.1, Claude Fable 5 52.9)
- APEX-Agents 1.1: 57.0 (terzo, Gemini 3.8 Flash 64.3, Claude Fable 5 63.6)
Vince su quattro dei sei benchmark rispetto a Claude Fable 5. Mostra invece una leggera regressione sui benchmark di coding (Terminal-Bench 2.1 83.2 vs 84.3 del base, DeepSWE 1.1 61.5 vs 63.4).
Costo, disponibilità e team
L’API è live su platform.paperinstruments.com con pricing identico a GLM-5.3 Flash: 0,15 dollari per milione di token in input, 0,03 in cached input e 0,50 in output. Il modello si chiama ultramarine-1-flash ed è compatibile con SDK OpenAI e Anthropic.
Daanish Khazi, CEO di Paper Instruments (YC S25, San Francisco), ha dichiarato che il post-training è costato circa 300mila dollari all-in a un team di cinque persone. I pesi arriveranno in circa due settimane. Il codice di training e l’harness sono già aperti.
Il modello è ottimizzato per prosa professionale, gerarchia visiva e deliverable puliti. Non ha training vision: le letture di immagini restituiscono osservazioni testuali.
Limiti e prospettiva
I punteggi più alti arrivano sui benchmark costruiti intorno a deliverable documentali. Su suite agentiche più complesse come APEX-Agents e DiligenceBench resta indietro rispetto ai modelli di frontiera. I dati sintetici permettono scala e controllo, ma possono non catturare tutte le sfumature delle tracce di produzione reali.
Per chi costruisce tool per banche, studi legali e consulenze, Ultramarine 1 Flash rappresenta un punto di riferimento concreto: un base model open, specializzato con RL non-verificabile a costi molto contenuti, con infrastruttura di training già rilasciata. La vera verifica arriverà con i pesi aperti e con i test su task di produzione.
Fonti
Testo: assistito da AI · revisionato da Carlos H. P. Ross