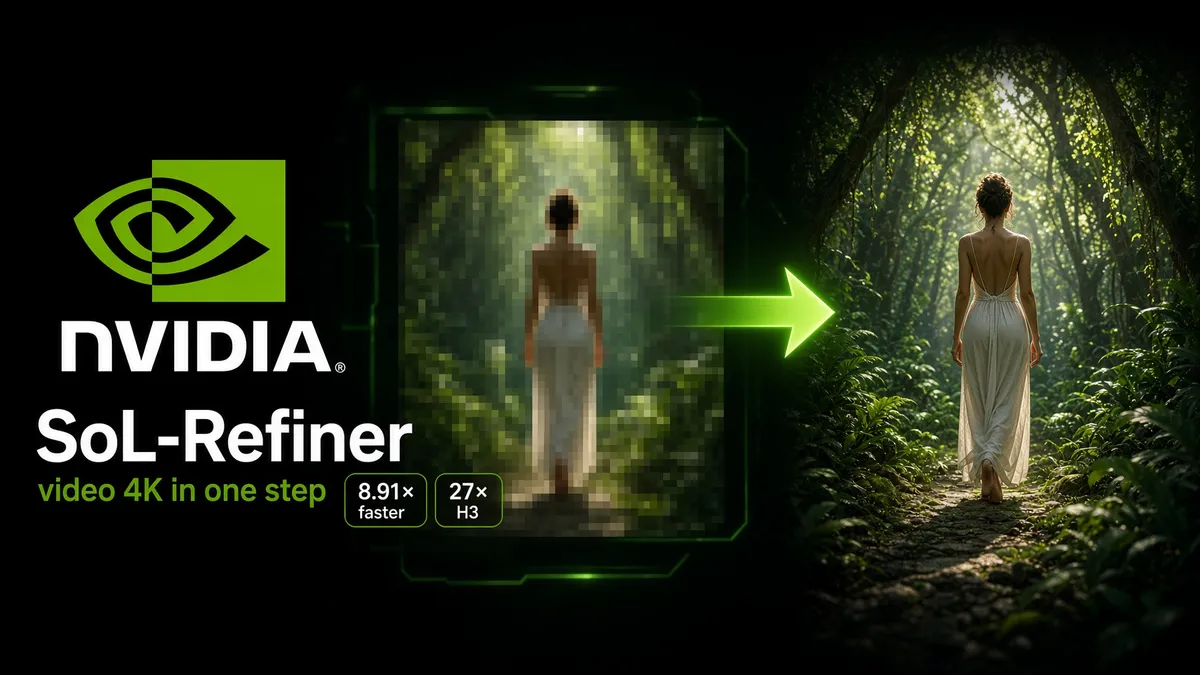
NVIDIA Research ha pubblicato SoL-Refiner, un refiner video che porta un output a bassa risoluzione fino a 4K con un solo step di denoising alla risoluzione target. Il paper arXiv:2609.37969, inviato il 29 settembre 2026, tratta il refinement multi-step come un secondo collo di bottiglia: generare in 4K costa perché i token spaziotemporali crescono in fretta, e rifinire con molti step ripete quel costo.
L’idea operativa è generare il draft dove il modello base è già economico, poi pagare un solo aggiornamento Euler sulla griglia alta. Il codice è nel branch sol-engine di NVlabs/Sana. I pesi sono nella collection SoL-Refiner su Hugging Face.
Tre stadi prima dello step unico
SoL-Refiner non è un generator da zero. Parte da un checkpoint LTX-2.3 di Lightricks e usa encoder, upsampler spaziale e decoder VAE di quella famiglia. Il training ha tre stadi, descritti nel paper.
Il primo è continual training ad alta risoluzione su coppie video a bassa fedeltà e alta fedeltà, con flow matching a sigma troncato. Il modello impara la mappa da draft a target, non a campionare una scena da rumore puro. Il secondo è post-training con reinforcement learning e reward sui frame. I modelli di reward citati sono HPSv3++ per la preferenza umana e DeQA per la qualità rispetto al degrado. Il reward combina i due segnali su un sottoinsieme di frame, con tetti a 10 e 4,5. Serve a spingere texture e dettaglio percepito, non a riscrivere la scena.
Il terzo comprime il refiner multi-step in un modello a uno step, con distribution matching distillation e una perdita avversaria da un discriminatore DiT proiettato. Il rilascio pubblico tiene anche la variante multi-step: 19 update Euler, sigma da 0,909 a 0, CFG 3. La one-step fa un update, sigma da 0,725 a 0, CFG 1.
Refiner-Bench, non una classifica di generator
Il benchmark introdotto nel paper, Refiner-Bench, usa 150 video prodotti da WAN 2.1 1.3B, SANA-Video 2B e LTX-2 stage 1. Copre 12 gruppi di contenuto, tre livelli di moto e sei movimenti di camera. Il protocollo è a input condiviso: tutti i refiner vedono gli stessi frame ridimensionati a 1024×576. Il confronto a circa 2K è sull’uscita 2048×1152.
A 2K la one-step fa 0,81048 di VBench medio e 60,4150 di UniPercept medio. Supera i refiner esterni valutati, tra cui SEEDVR2 a un passo (0,80351 e 56,8192) e il refiner LTX-2.3 a tre step (0,80388 e 56,1243). La variante a 23 step del gruppo resta più alta: lo step unico è un compromesso, non il tetto di qualità.
A 3840×2176 il confronto diretto è con il refiner LTX-2.3 a tre step. SoL-Refiner migliora la media VBench del 3,86% e la media UniPercept del 22,79%. La project page mostra la stessa ricetta su SANA-Video, WAN, Cosmos-Nano e MiniMax H3, senza riaddestrare il generator di base.
8,91× e 27× non sono lo stesso esperimento
Nel setting di latenza a 2K, il refiner one-step con tiny autoencoder e Sol-Engine scende da 57,461 a 6,447 secondi contro il refiner LTX-2.3 a tre step. È uno speedup di 8,91×. Il paper scompone il guadagno: distillazione one-step circa 1,82×, TAE circa 2,37×, Sol-Engine circa 2,06×.
Il 27,03× è un altro protocollo, sulla project page. Un video MiniMax H3 di cinque secondi, 1344×768 a 24 fps, su GPU NVIDIA GB200: full-res 152,3 secondi su una GPU. Il pipeline a due stadi usa una GPU per stadio, genera a 896×512 in 4,0629 secondi e rifinisce in 1,5567 secondi. Latenza end-to-end misurata: 5,6354 secondi.
Gli altri speedup di pipeline, su una H100, sono più contenuti e vanno letti sul protocollo dichiarato. SANA-Video: 20,04 secondi diretti a 1248×704 contro 12,54 secondi con draft 832×480 più refinement, 1,60×, 81 frame a 16 fps. WAN: 272,69 secondi diretti a 1280×720 contro 78,71 secondi, 3,46×, 81 frame a 24 fps. Cosmos-Nano: 2,81× sul protocollo a 189 frame e 24 fps. In tutti i casi la project page riporta anche un miglioramento della qualità media rispetto alla generazione diretta ad alta risoluzione.
Cosa si può usare oggi
I pacchetti vanno tenuti separati. La versione del paper poggia su LTX-2.3: SoL-Refiner-LTX-2.3-One-Step e la multi-step, indicata a 19 miliardi di parametri in BF16. L’estensione MiniMax H3 usa LTX-2.5 e un checkpoint diverso, SoL-Refiner-LTX-2.5-for-MiniMax-H3. Inference baseline e SoL-Engine condividono gli stessi pesi. Il paper è in licenza CC BY-NC-ND 4.0; la licenza dei pesi va letta sulla model card prima di un uso commerciale.
Il limite è nel compito. SoL-Refiner punta al dettaglio locale. Non è un correttore di errori semantici, geometrici o di moto del draft. I reward sui frame possono perdere coerenza temporale a lungo raggio. Il benchmark usa solo video generati, non degradazioni da camera reale. Se il draft ha una mano sbagliata o un’identità che cambia, un solo step di refinement non è il posto dove aspettarsi la correzione. Per una pipeline di consegna il disegno è chiaro: il grosso del denoising resta a risoluzione bassa, lo step target paga texture e risoluzione. Il 4K one-step è credibile sui numeri di Refiner-Bench. Il 27× vale solo per il caso H3 misurato su GB200, non come fattore universale.
Fonti
Testo: assistito da AI · revisionato da Carlos H. P. Ross