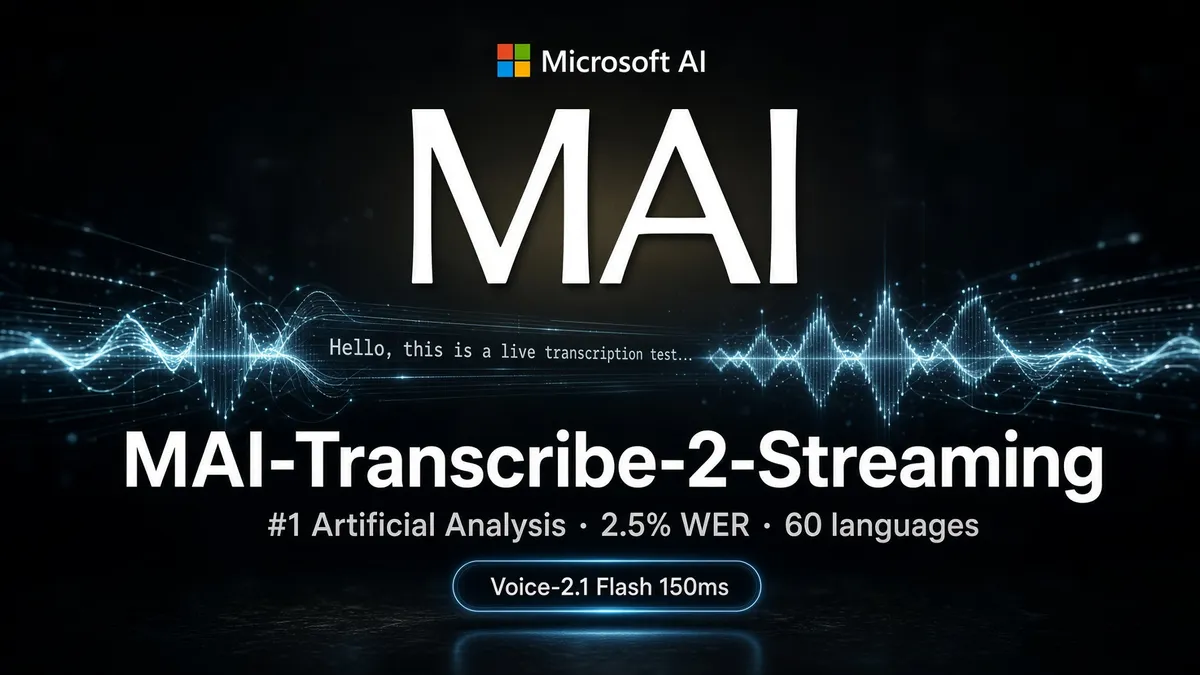
Il 1 ottobre 2026 Microsoft AI ha pubblicato MAI-Transcribe-2-Streaming, il primo modello di trascrizione in streaming della linea MAI, insieme a due modelli text-to-speech: MAI-Voice-2.1 e MAI-Voice-2.1-Flash. I tre modelli chiudono il loop di un voice agent: ascolto in tempo reale, risposta vocale, stessa identità di voce tra le lingue.
Non è un aggiornamento del batch di settembre. È il pezzo che mancava per far partire tool e ragionamento mentre l’utente sta ancora parlando.
Cosa fa MAI-Transcribe-2-Streaming
MAI-Transcribe-2-Streaming restituisce testo mentre l’audio entra. Le prime ipotesi, i partial, arrivano in poco più di 100 ms dalla ricezione dell’audio. Il modello le rivede man mano che arriva contesto e poi committa un transcript stabile.
Copre 60 lingue con language detection automatica e continua. La model card elenca, tra le altre, italiano, inglese, francese, tedesco, spagnolo, portoghese, cinese, giapponese, coreano, arabo, hindi, russo, polacco, turco, vietnamita e swahili. Il caso d’uso dichiarato è voice agent, sottotitoli live, dettatura e call experience: l’agente può preparare una tool call a frase ancora aperta. È il fratello in streaming di MAI-Transcribe-2, uscito il 3 settembre 2026. Quella versione batch resta in promo a 0,10 dollari l’ora fino a fine anno e, sul leaderboard non streaming di Artificial Analysis, risulta a 2,0% di AA-WER.
Il primo posto su Artificial Analysis
Microsoft dichiara il primo posto per accuratezza sia sul transcript finale sia sui partial, e una posizione sulla frontiera di Pareto accuratezza-latenza. La model card riporta la tabella AA sul transcript finale dopo la fine del parlato:
- MAI-Transcribe-2-Streaming: 2,5% WER
- Grok Transcribe 2.0: 2,7%
- Muse Voice Transcribe: 3,1%
- Cartesia Ink 2: 3,1%
- ElevenLabs Scribe V2 Realtime: 3,6%
- GPT-live Transcribe: 3,9%
Le ricostruzioni del leaderboard streaming (circa 8 ore di audio: AA-AgentTalk 50%, VoxPopuli 25%, Earnings22 25%, latenza misurata dalla fine del parlato con Silero VAD) mettono il finale a 2,5% WER in 0,13 secondi, primo su 38 modelli. Grok Voice Transcribe 2.0 era il riferimento precedente a 2,7% e 0,49 secondi. Muse sta a 3,1% e 0,16 secondi. Cartesia Ink-2 può chiudere il finale in circa 0,07 secondi, ma con WER più alto, intorno al 4% sugli endpoint esterni.
Il “2x più veloce” sulle parole che compaiono in dettatura e sottotitoli è una valutazione interna Microsoft, non un numero di Artificial Analysis. Il competitor non è nominato.
Prezzo e dove provarlo
Il prezzo introduttivo è 0,54 dollari per ora di audio fino a fine 2026. Artificial Analysis lo normalizza a circa 9 dollari per 1.000 minuti: sopra diverse offerte streaming di xAI e Meta, in linea con la stima su Gemini. Non è il modello più economico. È il più accurato del leaderboard streaming, a latenza competitiva.
Disponibilità dichiarata: Microsoft Foundry, MAI Playground, Vercel e Azure Voice Live. LiveKit è indicato come in arrivo. Nel Playground la demo Chatter fa girare i modelli insieme in un agente live.
Voice-2.1 e la variante Flash
MAI-Voice-2.1 è il TTS multilingue. Una sola voce usa 23 lingue e 26 locale con accento nativo in ciascuna: inglese US, UK, Australia e India, italiano, francese, tedesco, hindi, spagnolo di Spagna e Messico, portoghese brasiliano e europeo, coreano, cinese semplificato, turco, russo, thai, olandese e altre. Il cloning è zero-shot da pochi secondi di riferimento (la model card indica 5-60 secondi), senza fine-tuning, con guardrail sul consenso. L’accesso al cloning richiede approvazione Microsoft.
Sulla pagina modello l’inference è circa 550 ms per generare 45 secondi di audio, a 22 dollari per milione di caratteri. È il tier da fedeltà: audiolibri, voice-over, contenuti.
MAI-Voice-2.1-Flash tiene lingue, voce cross-language, controllo emotivo e cloning. Cambia il target. Genera 45 secondi di audio con latenza end-to-end di 150 ms. L’inference di modello è circa 45 ms. Il prezzo è 15 dollari per milione di caratteri. Microsoft scrive che l’inference è il 55% più veloce e il costo circa il 60% più basso rispetto a modelli comparabili: è un claim verso il mercato, non il delta interno. Verso Voice-2.1 il taglio di prezzo è da 22 a 15 dollari, circa il 32%, mentre l’inference pubblicata scende da circa 550 ms a circa 45 ms.
Flash è il partner naturale dello streaming per contact center, IVR e assistenti. Voice-2.1 resta quando conta la resa, non il turno.
Cosa cambia per chi costruisce agenti
Accoppiare lo streaming a Flash restituisce tempo su entrambi i lati del turno. L’agente può iniziare a ragionare sul partial e parlare con una latenza da conversazione, non da turn-taking. Tre usi citati da Microsoft: customer service che agisce prima che il chiamante chiuda la frase; assistenti che rilevano la lingua e rispondono in una delle 23 lingue con la stessa voce; learning e media con speaker distinti per tutoraggio, role-play e narrazione. Il limite va detto. Il primo posto è sul leaderboard streaming di Artificial Analysis al 1 ottobre 2026, non su ogni benchmark batch. Il prezzo orario introduttivo è più alto di alternative già sul mercato. Il cloning non è self-serve senza approvazione. LiveKit non è ancora collegato.
Fonti
Testo: assistito da AI · revisionato da Carlos H. P. Ross